네이버 키워드 분석 (검색어 트렌드, API 활용, 롱테일 키워드)
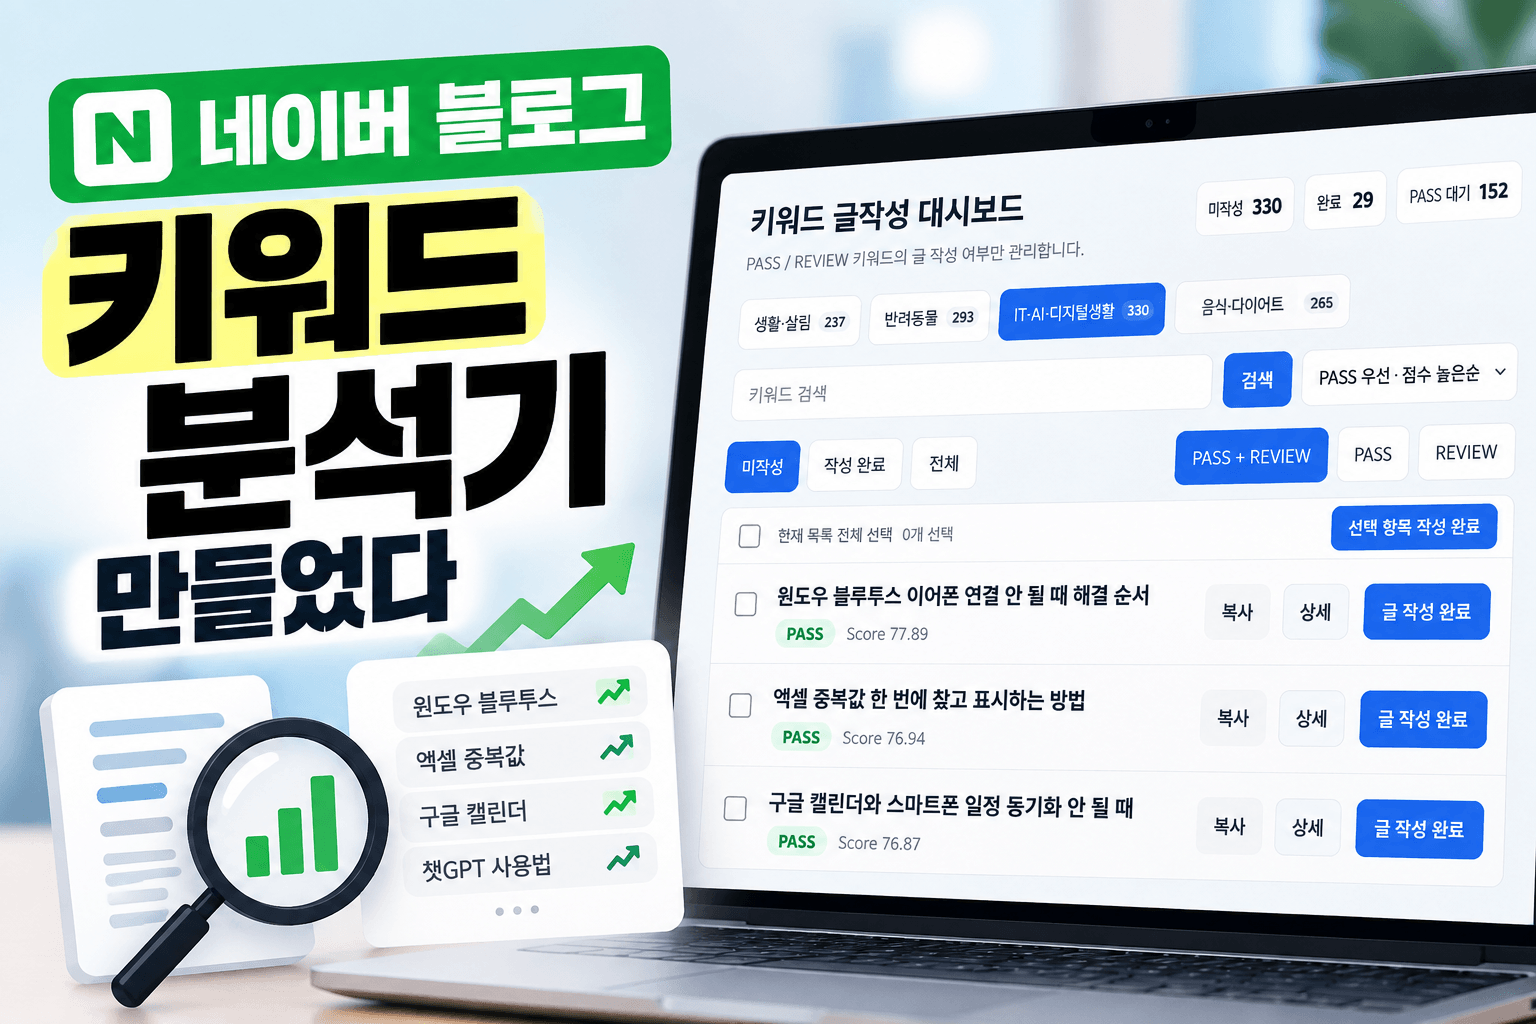
솔직히 저는 블로그 초반에 키워드가 이렇게 중요한 줄 몰랐습니다. 그냥 IT 관련 글을 열심히 올리면 조회수가 늘어날 거라 생각했는데, 몇 달이 지나도 유입이 거의 없었습니다. 그때서야 ‘어떤 키워드로 써야 사람들이 찾아올까’를 진지하게 고민하기 시작했고, 그 고민이 결국 직접 키워드 분석 도구를 만드는 데까지 이어졌습니다.
검색어 트렌드 API란 무엇인가
제가 처음 발견한 것이 네이버 API HUB의 검색어 트렌드 기능입니다. 네이버 API HUB란 네이버가 제공하는 다양한 데이터 서비스를 하나의 게이트웨이로 묶어 개발자에게 제공하는 플랫폼으로, 쉽게 말해 네이버의 내부 데이터를 코드로 가져올 수 있는 창구입니다. 그중에서 검색어 트렌드 API는 특정 키워드가 네이버 통합검색에서 얼마나 자주 검색되는지 시계열 데이터로 확인할 수 있게 해줍니다.
이 API가 반환하는 핵심 수치는 ratio, 즉 상대적 검색 비율입니다. ratio란 조회 기간 내에서 검색량이 가장 높았던 구간을 100으로 설정하고, 나머지 구간을 그에 대한 상댓값으로 표현한 지표입니다. 예를 들어 어떤 달의 ratio가 74라면, 가장 검색량이 많았던 달 대비 74% 수준의 검색이 일어났다는 뜻입니다. 절댓값이 아니라는 점이 처음에 헷갈렸는데, 그래도 트렌드의 방향성을 파악하는 데는 충분히 쓸 만합니다.
API 호출 방식은 RESTful API 방식을 따릅니다. RESTful API란 HTTP 프로토콜을 이용해 서버에 요청을 보내고 JSON 형태로 응답을 받는 구조로, 개발자라면 curl이나 Python의 requests 라이브러리로 바로 붙일 수 있습니다. 엔드포인트는 네이버 클라우드 공식 문서에 정리된 대로 POST 방식으로 요청하고, 헤더에 Client ID와 Client Secret을 넣으면 됩니다. 제가 직접 연결해봤을 때 응답 속도도 빠른 편이었고, 구조 자체도 단순해서 처음 API를 다뤄보는 분들에게도 진입 장벽이 높지 않았습니다.
요청 시 설정할 수 있는 파라미터를 정리하면 이렇습니다.
- startDate / endDate: 조회 기간 설정, 2016년 1월 1일부터 조회 가능
- timeUnit: 일간(date), 주간(week), 월간(month) 중 선택
- keywordGroups: 최대 5개 주제어 묶음, 각 묶음에 최대 20개 검색어 포함 가능
- device: PC 또는 모바일 검색 환경 필터링
- gender / ages: 성별 및 연령대 세분화 필터
특히 gender와 ages 필터는 제가 예상보다 유용하게 쓰고 있는 기능입니다. IT 콘텐츠의 경우 30대 남성 검색 비율이 높다는 걸 데이터로 확인하고 나서 타깃 독자 설정에 실제로 반영했습니다.
API 활용, 직접 연결해서 알게 된 것들
제가 만든 흐름은 이렇습니다. 먼저 작성하고 싶은 IT 주제를 정한 다음, ChatGPT에게 “이 주제로 사람들이 네이버에서 검색할 법한 롱테일 키워드를 36개 뽑아줘” 식의 프롬프트를 던집니다. 롱테일 키워드(Long-tail Keyword)란 검색량은 적지만 의도가 구체적인 검색어로, 경쟁이 낮아 블로그처럼 도메인 파워가 약한 사이트도 상위 노출 가능성이 있는 키워드입니다. 그 리스트를 API에 넣어서 각 키워드의 ratio를 확인하는 방식이었습니다.
처음에는 이게 꽤 효율적이라고 생각했습니다. 그런데 써보면서 문제를 발견했습니다. AI가 뽑아준 키워드가 실제로 사람들이 검색하는 표현이 아닌 경우가 꽤 있었다는 겁니다. 예를 들어 “파이썬 비동기 처리 최적화 방법”처럼 기술적으로 정확하지만 일반 사용자는 절대 그렇게 검색하지 않는 구조의 키워드들이 섞여 있었습니다. API 데이터상으로는 ratio가 0에 가깝게 나오는 키워드들이었는데, 이건 검색량이 없는 게 아니라 아예 그 표현으로 검색하는 사람이 없다는 뜻입니다.
결국 제가 내린 판단은 키워드 수집 단계와 검색량 측정 단계를 분리해야 한다는 것이었습니다. AI는 키워드 측정 도구로 쓰기엔 맞지 않고, 브레인스토밍 용도로만 제한적으로 활용하는 게 맞는 방향으로 보입니다. 실제로 사람들이 무엇을 궁금해하는지는 네이버 검색창의 연관 검색어 API나 자동완성 데이터, 또는 블랙키위처럼 실제 검색 데이터 기반의 서비스(블랙키위 바로가기)를 함께 써야 정확도가 올라갑니다.
또 한 가지 놓치기 쉬운 부분이 있습니다. 검색량이 높다고 해서 그 키워드가 블로그에 좋은 키워드인 건 아닙니다. 검색 경쟁도(Search Competition)란 동일 키워드로 이미 작성된 문서의 수와 품질을 의미하는데, 검색량이 아무리 높아도 경쟁 문서가 이미 수만 개라면 신규 블로그가 비집고 들어갈 틈이 없습니다. 이 부분은 API가 직접 제공하지 않기 때문에, 저는 네이버 검색 결과 페이지에서 해당 키워드의 블로그 탭 노출 수를 직접 확인하는 방식으로 보완하고 있습니다.
롱테일 키워드 전략, 어떻게 바꿔가고 있는가
제 경험상 검색어 트렌드 API의 진가는 단순히 키워드 하나의 검색량을 보는 게 아니라, 복수의 키워드를 비교하는 데 있습니다. keywordGroups 파라미터에 최대 5개의 주제어 묶음을 넣을 수 있는데, 이걸 활용하면 “도커 설치”와 “도커 사용법”, “도커 오류 해결”처럼 동일 주제 내에서 어떤 표현이 더 자주 검색되는지 한눈에 비교할 수 있습니다. 솔직히 이건 제가 API를 써보고 나서야 알게 된 활용법이었습니다.
월간(month) 단위로 조회하면 계절성 트렌드도 잡힙니다. 시계열 분석(Time-series Analysis)이란 시간 흐름에 따른 데이터 변화 패턴을 읽는 방법인데, 예를 들어 “취업 준비”나 “자격증” 관련 키워드는 매년 특정 월에 검색량이 집중된다는 걸 데이터로 확인할 수 있습니다. IT 주제도 마찬가지로 신기술이 발표되는 시점이나 특정 시험 일정과 맞물려 검색이 몰리는 패턴이 있어서, 그걸 미리 파악하고 한두 달 전에 글을 써두면 유입 타이밍을 잡을 수 있습니다.
앞으로 제가 바꾸려는 흐름은 이렇습니다. AI에게 키워드 초안을 받더라도 그것을 그대로 API에 넣지 않고, 네이버 연관 검색어나 블랙키위 같은 실제 사용자 검색 기반 데이터로 한 번 필터링한 다음에 API로 검색량을 측정하는 방식입니다. Title Match란 특정 키워드가 블로그 글의 제목에 정확하게 포함된 경우를 뜻하는데, 이 수치가 낮을수록 경쟁이 덜하다는 신호로 해석할 수 있습니다. 검색량과 Title Match 수를 함께 보는 것이 훨씬 정교한 키워드 선별 방식입니다.
데이터 기반 블로그 운영이라는 게 거창하게 들릴 수 있지만, 결국은 내가 쓰고 싶은 주제와 사람들이 찾는 표현 사이의 간극을 좁히는 작업입니다. 그 간극을 데이터로 측정하는 도구가 바로 이 API입니다.
자주 묻는 질문
Q. 네이버 검색어 트렌드 API는 무료로 사용할 수 있나요?
A. 네이버 API HUB를 통해 이용하며, Classic 또는 VPC 환경에서 사용 가능합니다. 기본적으로 네이버 클라우드 플랫폼 계정이 필요하고, 일정 사용량까지는 무료로 제공됩니다. 정확한 요금 정책은 네이버 클라우드 공식 페이지에서 확인하는 것이 가장 정확합니다.
Q. ratio 수치가 0으로 나오면 해당 키워드는 아예 검색이 안 된다는 뜻인가요?
A. 꼭 그런 건 아닙니다. ratio는 조회 기간 내 최대값을 100으로 설정한 상댓값이기 때문에, 다른 키워드 대비 상대적으로 매우 낮거나 거의 없는 수준이라는 의미입니다. 절대 검색량이 0임을 의미하지는 않지만, 실질적으로 콘텐츠 작성 우선순위에서는 후순위로 두는 게 맞습니다. 제가 AI가 만들어준 키워드를 넣었을 때 0이 많이 나왔던 이유가 바로 이것이었습니다.
Q. 블로그 키워드 분석에 API 말고 다른 방법은 없나요?
A. 블랙키위, 키워드마스터, 네이버 광고 시스템의 키워드 도구 등이 코딩 없이 활용할 수 있는 대안입니다. 다만 이런 서비스들은 대부분 절대 검색량을 보여주는 반면, API는 비교 분석과 필터링 기능이 더 유연하다는 장점이 있습니다. 두 가지를 병행하는 게 가장 효율적입니다.
Q. keywordGroups에 여러 검색어를 묶는 게 의미가 있나요?
A. 있습니다. 같은 주제를 다르게 표현한 검색어들, 예를 들어 “파이썬”과 “python”을 하나의 그룹으로 묶으면 두 표현을 합산한 트렌드로 볼 수 있습니다. 반대로 표현별로 따로 나눠서 그룹을 구성하면 어떤 표현이 더 자주 쓰이는지 비교가 가능합니다. 목적에 따라 구성을 달리하는 게 포인트입니다.
지금까지 써온 방식에 문제가 있다는 걸 인정하고 나니, 오히려 다음 단계가 더 명확해졌습니다. 키워드 수집은 실제 사용자 데이터에서, 검색량 측정은 API로, 경쟁도 확인은 직접 검색으로 하는 세 단계 흐름을 정착시키는 것이 당장의 목표입니다. 이 과정을 계속 다듬어가면서 어떤 변화가 생기는지도 이후 글에서 공유할 생각입니다.
—
참고: https://api.ncloud-docs.com/docs/naver-api-hub-search-trend
https://blackkiwi.net