IndexedDB 오류 복구 (Object Store, 버전 관리, CRUD 분리)
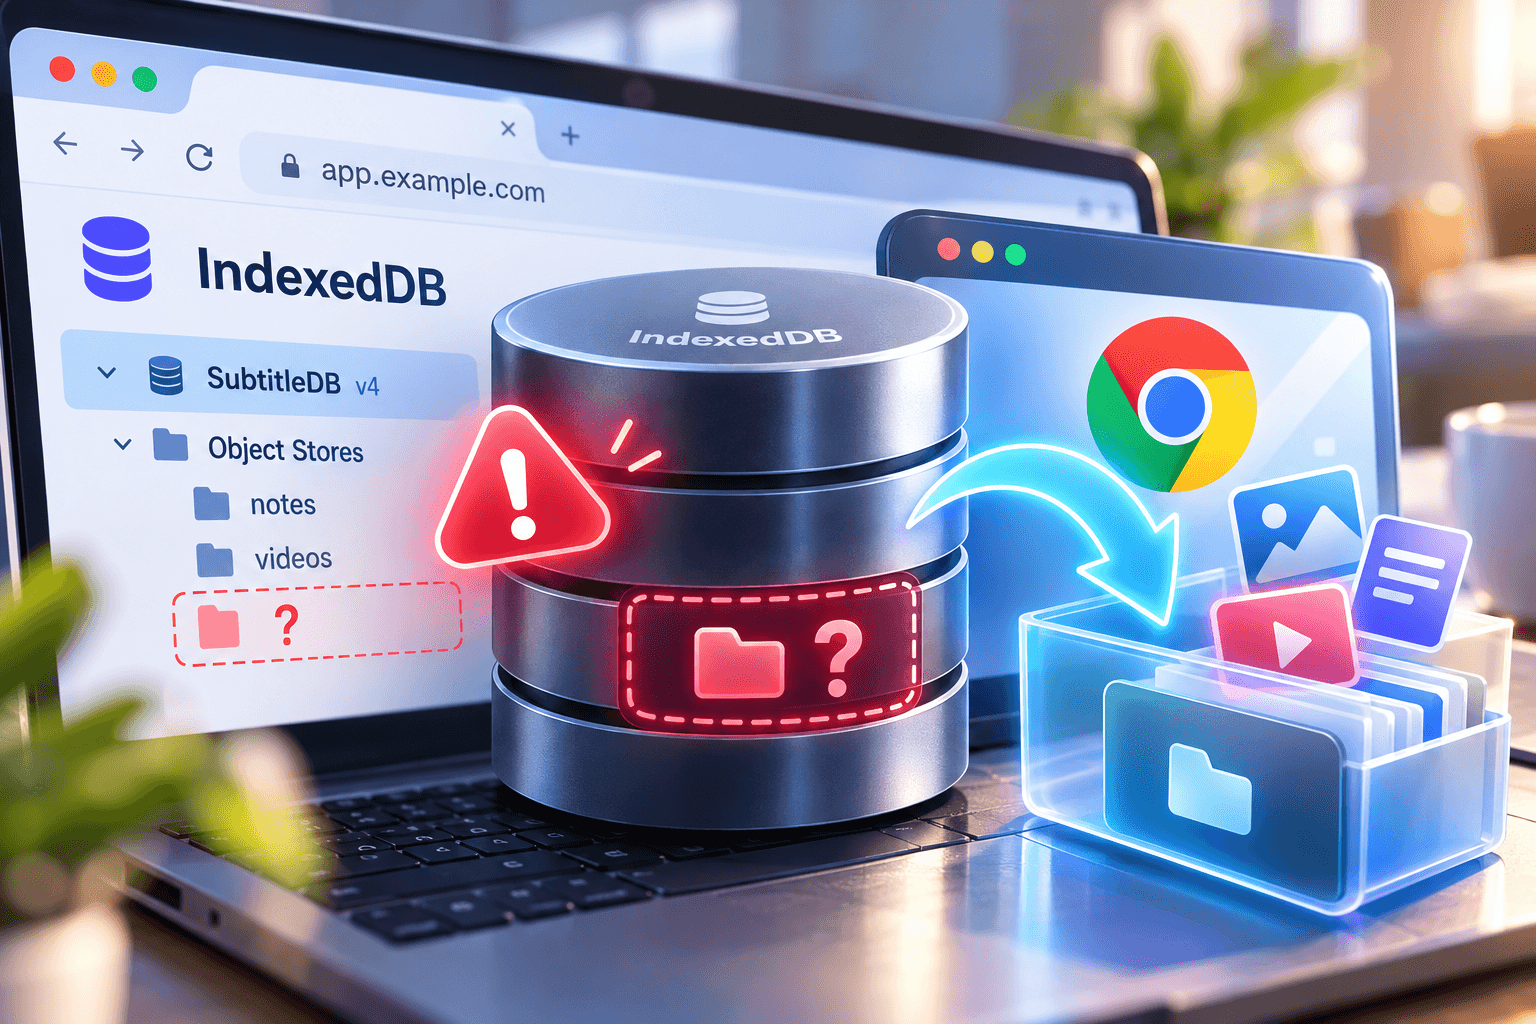
IndexedDB에서 데이터베이스는 멀쩡히 열리는데 트랜잭션을 시작하는 순간 NotFoundError가 터졌습니다. 데이터베이스 자체는 존재하는데 내부 Object Store가 사라진 상황, 저도 처음엔 무슨 상황인지 파악하는 데만 한참 걸렸습니다. 이 글은 그 과정에서 직접 부딪혔던 버전 관리 문제와 CRUD 구조 개선 경험을 정리한 것입니다.
Object Store가 사라지면 버전 번호가 해결해 줄까요?
오류 메시지는 명확했습니다. “One of the specified object stores was not found.” 개발자 도구를 열어보니 SubtitleDB 데이터베이스는 버전 4로 존재하고 있었는데, 그 안에 있어야 할 captions라는 Object Store가 없었습니다. Object Store란 IndexedDB에서 데이터를 실제로 담아두는 공간으로, 관계형 데이터베이스의 테이블에 해당하는 개념입니다.
처음에는 onupgradeneeded 이벤트가 자동으로 복구해줄 거라고 생각했습니다. 하지만 이 이벤트는 데이터베이스가 처음 생성되거나, 기존 버전보다 높은 버전 번호로 열릴 때만 실행됩니다. 이미 버전 4인 데이터베이스를 다시 버전 4로 열면, Object Store가 없어졌다는 이유만으로 이 이벤트가 실행되지는 않습니다. 저도 이 부분에서 한참 헤맸는데, 데이터베이스 버전과 내부 구조가 항상 일치한다는 가정 자체가 틀렸던 것입니다.
그렇다면 버전을 5로 올리면 되지 않을까요? 여기서 또 다른 문제가 생깁니다. 실제 서비스에서 Object Store가 사라지는 문제가 발생한 사용자가 누구인지 미리 알 수 없습니다. 정상적으로 버전 4를 사용하는 사용자 9명에게도 코드 버전을 5로 올리면 불필요한 업그레이드가 발생합니다. 더 심각한 경우, 어떤 사용자가 이미 버전 5의 데이터베이스를 가지고 있다면 낮은 버전으로 열려는 시도에서 VersionError가 발생할 수 있습니다. VersionError란 요청한 버전이 현재 데이터베이스에 저장된 버전보다 낮을 때 발생하는 오류입니다.
결국 모든 사용자의 버전을 개별적으로 추적하는 대신, 애플리케이션이 직접 데이터베이스 구조를 확인하고 필요한 경우에만 복구하는 방식이 훨씬 현실적이라는 판단을 내렸습니다. MDN의 IndexedDB 공식 문서에서도 onupgradeneeded 이벤트가 스키마 변경의 유일한 진입점임을 명시하고 있는데, 이 구조를 잘 이용하면 동적으로 버전을 올리는 복구 로직을 만들 수 있습니다.
- 버전을 지정하지 않고 데이터베이스를 먼저 열어 현재 버전을 확인합니다.
- 필요한 Object Store가 존재하는지 objectStoreNames로 검사합니다.
- Object Store가 있으면 그대로 연결을 반환합니다.
- Object Store가 없으면 기존 연결을 닫고 현재 버전보다 1 높은 버전으로 다시 엽니다.
- onupgradeneeded 안에서 누락된 Object Store와 인덱스를 생성하고 연결을 반환합니다.
이 방식의 한계도 솔직히 말씀드리면, Object Store 구조는 복구할 수 있지만 그 안에 있던 기존 데이터는 돌아오지 않습니다. 사라진 데이터를 복구하는 기능이 아니라, 애플리케이션이 깨지지 않고 계속 동작할 수 있도록 구조를 보장하는 것이 이 함수의 역할입니다.
인덱스 기반 CRUD, 어디서 실수가 생기기 쉬울까요?
Object Store 복구 문제를 해결하고 나서 CRUD 함수를 정리하면서 생각보다 놓치기 쉬운 부분들을 발견했습니다. CRUD란 데이터의 생성(Create), 조회(Read), 수정(Update), 삭제(Delete)를 의미하는 용어입니다. 특히 삭제와 수정 기능에서 기본 키와 애플리케이션 식별자를 혼동하면 예상과 다른 동작이 나옵니다.
저의 경우 Object Store의 기본 키는 autoIncrement로 자동 생성되는 id로 설정했습니다. 그런데 실제 코드에서 메모를 구분할 때 사용하는 값은 anno_id였습니다. 처음에 store.delete(anno_id)를 작성했다가 아무것도 삭제되지 않는 상황이 발생했는데, delete() 메서드는 기본 키 값을 기준으로 동작하기 때문입니다. anno_id가 기본 키가 아니면 당연히 아무 레코드도 찾지 못합니다.
이런 경우에는 인덱스(Index)를 사용해야 합니다. 인덱스란 특정 속성 값을 기준으로 레코드를 빠르게 조회할 수 있도록 Object Store에 미리 구성해둔 탐색 구조입니다. anno_id 인덱스를 만들어두고, openCursor로 해당 값을 가진 레코드를 찾은 다음 커서(Cursor)를 통해 delete()를 호출하면 기본 키를 직접 몰라도 삭제가 가능합니다. 커서란 Object Store나 인덱스를 순회하면서 개별 레코드에 접근할 수 있게 해주는 포인터 개념입니다.
수정 역시 같은 방식입니다. 커서로 레코드를 찾은 뒤 cursor.update()를 호출할 때 기존 레코드를 스프레드 연산자로 복사하고 변경할 필드만 덮어쓰면, autoIncrement로 생성된 id가 유지되면서 수정이 이루어집니다. 제가 처음에 새 객체를 통째로 put()으로 넣었다가 id가 바뀌어버린 경험이 있는데, 기존 값을 기반으로 수정하는 패턴이 훨씬 안전합니다. 또한 createdAt과 updatedAt을 분리해서 기록해두면 나중에 데이터 변경 이력을 추적할 때 유용합니다.
트랜잭션(Transaction) 모드 선택도 빠뜨리기 쉬운 부분입니다. 트랜잭션이란 데이터베이스에 대한 하나의 논리적 작업 단위로, 읽기만 할 때는 readonly, 데이터를 변경할 때는 반드시 readwrite로 지정해야 합니다. W3C IndexedDB 명세에서는 읽기 전용 트랜잭션이 동시에 여러 개 실행될 수 있는 반면, readwrite 트랜잭션은 같은 Object Store에 대해 동시에 하나만 실행된다고 명시합니다. 무분별하게 readwrite를 사용하면 성능에 영향이 생길 수 있습니다.
코드를 파일로 나누면 무엇이 달라지나요?
처음에는 메모 저장, 조회, 삭제 코드를 React 컴포넌트 안에 직접 작성했습니다. 기능이 몇 개 없을 때는 그래도 관리가 됐지만, 자막 저장과 메모 CRUD가 추가되면서 데이터베이스를 여는 코드가 여러 곳에 흩어지기 시작했습니다. 솔직히 이건 예상 밖이었습니다. 처음부터 분리해두지 않으면 나중에 수정할 때 얼마나 손이 많이 가는지 실감했습니다.
그래서 역할을 세 개 파일로 나누었습니다. ensureStore.ts는 데이터베이스를 열고 필요한 Object Store의 존재를 보장하는 역할만 합니다. dbFunctions.ts는 자막과 메모의 저장, 조회, 수정, 삭제 로직을 담습니다. GlobalFunctions.tsx는 외부 JavaScript에서 호출할 수 있도록 함수를 window 객체에 등록하는 역할만 맡습니다.
외부 JavaScript 연동 때문에 window.saveMemo 같은 전역 함수 인터페이스는 유지해야 했습니다. 하지만 전역 함수 안에 데이터베이스 처리 로직까지 넣어두는 것은 다른 문제입니다. GlobalFunctions는 현재 선택된 videoId와 lang을 React Context에서 받아와 dbFunctions의 함수에 전달하는 얇은 연결 레이어 역할만 하면 됩니다. Context란 React에서 컴포넌트 트리 전체에 값을 공유할 수 있도록 해주는 상태 관리 메커니즘입니다.
이 구조를 적용하고 나서 데이터베이스 연결 방식을 변경해야 할 일이 생겼을 때, ensureStore.ts 파일 하나만 수정하면 됐습니다. 이전이었다면 여러 컴포넌트를 찾아다니며 각각 수정해야 했을 것입니다. 코드를 나누는 것이 초반에는 번거롭게 느껴질 수 있지만, 제 경험상 이건 나중에 반드시 보답이 돌아오는 작업입니다.
자주 묻는 질문
Q. IndexedDB의 Object Store가 갑자기 사라지는 이유가 뭔가요?
A. 브라우저 데이터 정리, 개인정보 보호 모드 전환, 또는 개발 중 데이터베이스를 수동으로 삭제한 뒤 버전은 그대로 남는 경우 등에서 발생할 수 있습니다. 데이터베이스 자체가 남아 있어도 내부 Object Store는 사라질 수 있기 때문에, 연결 성공만으로 구조가 정상이라고 가정해서는 안 됩니다. objectStoreNames로 존재 여부를 확인하는 로직을 넣어두는 것이 안전합니다.
Q. onupgradeneeded를 실행하려면 무조건 버전을 올려야 하나요?
A. 맞습니다. onupgradeneeded는 데이터베이스가 처음 생성되거나 기존 버전보다 높은 버전 번호로 열릴 때만 실행됩니다. Object Store가 사라졌다고 해서 같은 버전으로 다시 열 때 이 이벤트가 발생하지는 않습니다. 현재 버전을 먼저 읽고 1을 더해서 다시 열면 onupgradeneeded를 강제로 실행할 수 있습니다.
Q. IndexedDB에서 기본 키가 아닌 값으로 삭제하려면 어떻게 해야 하나요?
A. store.delete()는 기본 키를 기준으로만 동작합니다. 기본 키가 아닌 속성으로 삭제하려면, 해당 속성에 인덱스를 만들어두고 openCursor()로 레코드를 찾은 다음 커서의 delete() 메서드를 호출해야 합니다. IDBKeyRange.only()를 함께 사용하면 특정 값을 가진 레코드만 대상으로 커서를 열 수 있습니다.
Q. 외부 JavaScript에서 React 컴포넌트의 상태를 함께 써야 할 때 어떻게 연결하나요?
A. videoId나 lang처럼 사용자 선택에 따라 바뀌는 값은 React Context로 관리하고, 전역 함수를 등록하는 컴포넌트에서 Context의 최신 값을 받아 window 함수에 반영하는 방식이 실용적입니다. 이렇게 하면 외부 JavaScript는 항상 현재 선택된 상태를 기준으로 데이터베이스 함수를 호출할 수 있습니다.
Q. readwrite 트랜잭션은 무조건 피해야 하나요?
A. 데이터를 실제로 변경할 때는 readwrite 트랜잭션이 반드시 필요합니다. 다만 같은 Object Store에 대해 readwrite 트랜잭션은 동시에 하나만 실행될 수 있기 때문에, 읽기만 하는 경우에는 readonly를 쓰는 것이 성능상 유리합니다. 습관적으로 readwrite를 사용하면 불필요한 대기가 생길 수 있습니다.
IndexedDB는 서버 없이 브라우저에 데이터를 저장할 수 있는 강력한 수단이지만, 데이터베이스 구조가 항상 코드와 일치한다는 보장이 없다는 점을 이번에 직접 경험했습니다. Object Store 존재 여부를 확인하고 필요하면 복구하는 ensureStore 패턴, 인덱스 기반 CRUD 처리, 그리고 역할에 따른 파일 분리, 이 세 가지를 함께 적용하면 개발 중에도 운영 중에도 훨씬 안정적인 브라우저 저장소 관리가 가능합니다. IndexedDB를 처음 도입하는 분이라면 단순한 CRUD 구현보다 구조 보장 로직을 먼저 설계해두는 것을 권장합니다.
—
참고: https://developer.mozilla.org/ko/docs/Web/API/IndexedDB_API/Using_IndexedDB
https://www.w3.org/TR/IndexedDB/