mPDF 테이블 버그 (colspan, width, 디버깅)
3시간 동안 코드를 들여다봤는데, 범인은 딱 한 줄짜리 width 속성이었습니다. mPDF로 HTML 테이블을 PDF로 변환할 때 colspan이 걸린 첫 번째 td의 width 값이 다음 행 첫 번째 열에 그대로 상속되는 버그, 저도 이걸 직접 겪기 전까지는 상상도 못 했습니다. 공식 문서에도, ChatGPT에도 없는 답을 결국 개발 감각으로 찾아낸 이야기를 공유합니다.
라벨 디자인 변경, 어디서부터 꼬이기 시작했나
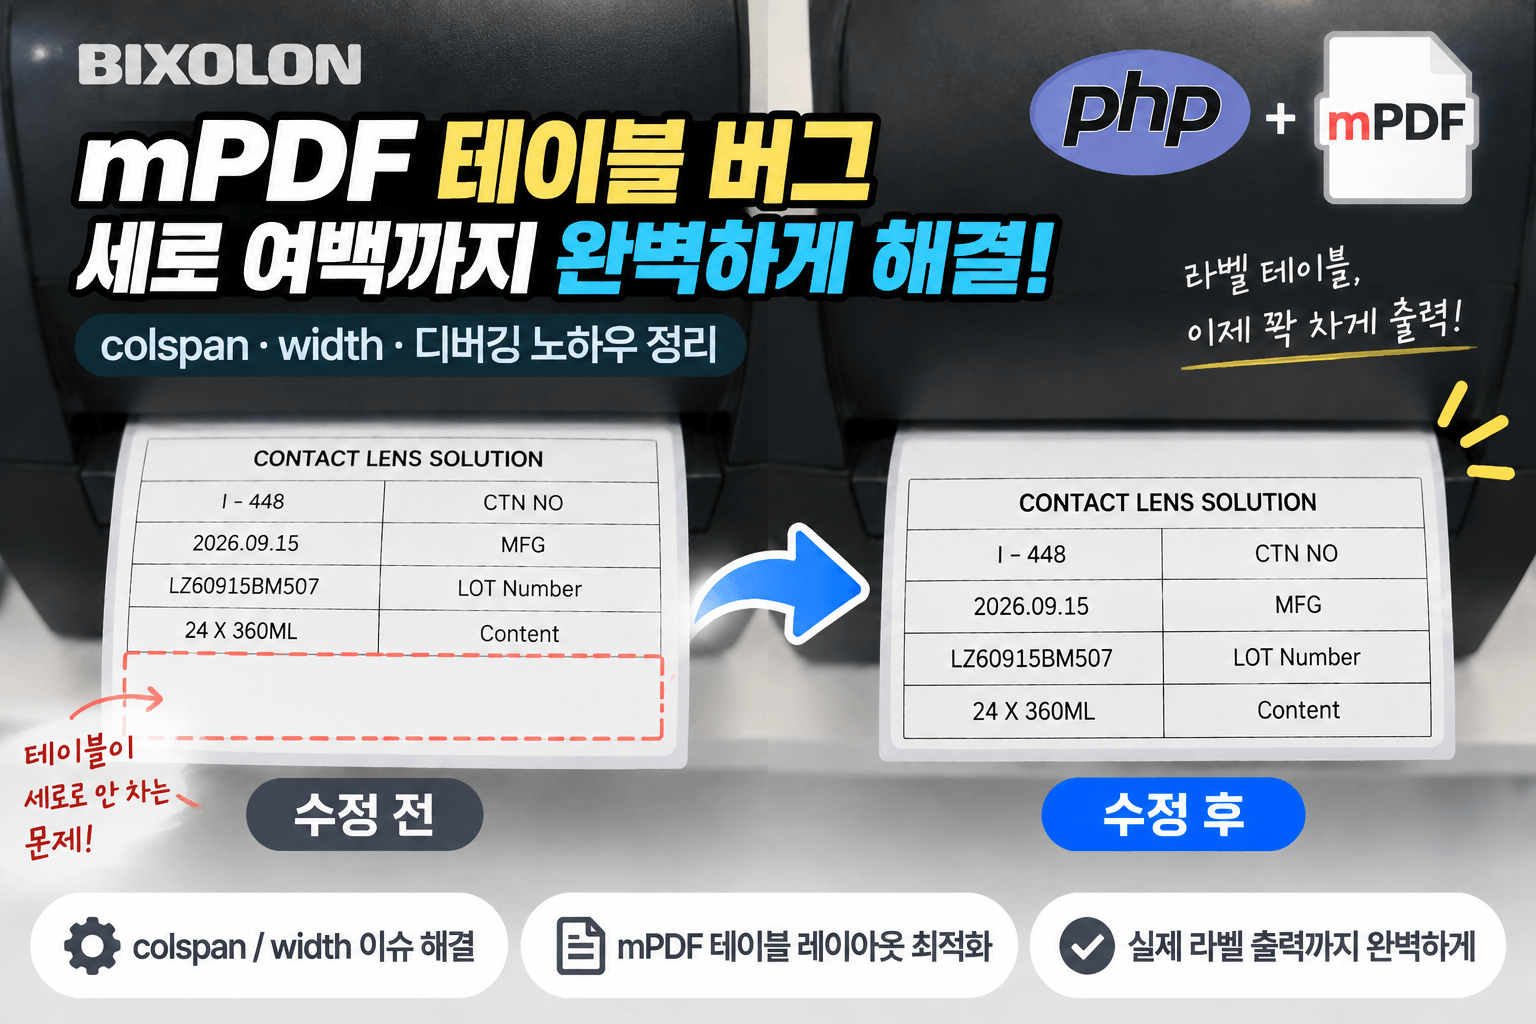
이번 작업은 단순해 보였습니다. 기존 라벨은 항목명과 항목 내용이 2열로 깔끔하게 5행까지 이어지는 구조였는데, 새로운 라벨은 첫 행만 달랐습니다. 제품명이 열 구분 없이 가로로 꽉 차게 들어가고, 그 아래부터 다시 항목명·내용의 2열 구조로 돌아가는 형태였습니다. “이 정도야 금방이지” 싶었던 게 솔직한 첫 반응이었습니다.
HTML 테이블로 먼저 구조를 잡았습니다. 첫 번째 행은 colspan=”4″로 4개 열을 합쳐서 제품명을 넣었고, 두 번째 행부터는 2열 구조로 항목명과 내용을 배치했습니다. 브라우저에서 열어보니 완벽했습니다. 라벨 크기도 딱 맞고, 텍스트 정렬도 깔끔했습니다. 그런데 이걸 mPDF로 변환하는 순간, 테이블이 이상하게 뭉개졌습니다.
colspan(열 병합)이란 HTML 테이블에서 하나의 셀이 여러 열을 가로질러 차지하도록 만드는 속성입니다. 예를 들어 colspan=”4″면 그 셀 하나가 4개 열의 너비를 모두 차지합니다. 브라우저에서는 이 규칙이 정확하게 지켜졌는데, mPDF에서는 달랐습니다.
width 속성이 만들어낸 황당한 버그
변환된 PDF를 보니 테이블 행의 높이가 전체적으로 쪼그라들어 있었습니다. 처음에는 페이지 여백 설정 문제인가 싶었고, 다음에는 폰트 크기 때문인가도 의심했습니다. ChatGPT에 증상을 설명하고 원인을 물어봤지만 돌아오는 답은 전부 엉뚱한 방향이었습니다. 여백 조정 해보라, 폰트 재설정 해보라, 이런 식이었습니다. 제가 직접 써봤는데, AI가 제안하는 방법을 하나씩 적용해봐도 증상은 전혀 달라지지 않았습니다.
결국 저는 원점으로 돌아와 테이블의 각 셀 width 값을 하나씩 추적하기 시작했습니다. 그러다 발견한 것이 충격적이었습니다. 첫 번째 행의 td에 지정한 width:278.25pt 값이, 두 번째 행 첫 번째 td의 너비로 그대로 적용되고 있었습니다. colspan=”4″로 4개 열을 합친 셀의 width가, 병합과 무관하게 바로 다음 행의 단독 열 너비로 상속된 것입니다.
오토레이아웃 알고리즘(auto-layout algorithm)이란 HTML 명세에서 권장하는 테이블 크기 계산 방식으로, 각 셀의 내용과 속성을 바탕으로 열 너비를 자동으로 결정하는 로직입니다. mPDF는 이 알고리즘을 자체적으로 구현하고 있는데(출처: mPDF 공식 문서), 이 과정에서 colspan 셀의 width 값 처리에 예상과 다른 동작이 나타난 것으로 보입니다. 결과적으로 첫 행의 278.25pt가 두 번째 행 첫 열의 너비로 인식되었고, 전체 테이블 너비가 라벨 크기를 크게 초과하게 됩니다. mPDF는 이걸 라벨 크기 안에 우겨 넣으려고 테이블 전체를 비율대로 축소했고, 그 결과가 찌그러진 행 높이였던 겁니다.
솔직히 이건 예상 밖이었습니다. HTML 명세대로라면 colspan=”4″ 셀의 width는 병합된 4개 열의 합산 너비로 해석되어야 하고, 개별 열 너비 결정에 직접 영향을 미치면 안 됩니다. 그런데 mPDF 8.0.x 버전에서는 그렇게 동작하지 않았습니다.
정규식 한 줄로 버그를 우회한 방법
원인을 파악하고 나니 해결 방향은 명확했습니다. 문제의 핵심은 첫 번째 td의 width 속성 자체였으니, 그걸 제거하면 됩니다. colspan으로 병합된 셀은 개별 열 너비 합산으로 크기가 결정되니, width를 따로 지정할 필요도 없었습니다.
정규식(regular expression)이란 특정 패턴을 가진 문자열을 찾아내거나 변환하는 데 쓰이는 표현 방식입니다. PHP의 preg_replace() 함수를 활용해서 HTML 문자열에서 colspan=”4″ 조건이 붙은 td 태그에서만 width 속성을 제거하도록 처리했습니다. 코드는 다음 한 줄로 끝났습니다.
3시간의 삽질 끝에 추가된 코드가 딱 한 줄이라는 게 얼마나 허탈했는지 모릅니다. 그런데 이게 개발의 현실이기도 합니다. 버그를 찾는 데 99%의 시간이 들고, 고치는 데는 1%면 충분한 경우가 생각보다 많습니다. mPDF가 HTML을 해석하는 내부 로직을 처음부터 끝까지 분석할 수는 없으니, 결국 증상을 관찰하고 원인을 역추적하는 수밖에 없었습니다.
이처럼 mPDF에서 테이블 레이아웃을 다룰 때는 몇 가지 상황을 미리 고려해두면 도움이 됩니다.
- colspan이 적용된 셀에는 width 속성을 가급적 지정하지 않는다. 병합 셀의 너비는 하위 열 너비의 합으로 결정되도록 맡기는 것이 안전합니다.
- HTML 브라우저 렌더링과 mPDF 변환 결과를 반드시 별도로 검증한다. 브라우저에서 완벽해도 mPDF에서는 전혀 다르게 나올 수 있습니다.
- 테이블 전체가 비정상적으로 축소될 때는 width 값의 합산이 페이지 또는 라벨 너비를 초과하는지 먼저 확인한다.
- $mpdf->shrink_tables_to_fit 옵션 값을 점검한다. 이 값이 활성화된 상태에서 width 합산이 넘치면 전체 비율 축소가 발생합니다.
- mPDF의 $keep_table_proportions 설정을 이해해둔다. 이 옵션은 테이블 너비가 페이지를 초과할 때 상대 비율을 유지한 채 축소할지 여부를 결정합니다.
AI도 못 찾은 버그, 개발 감각이 결국 답이었다
이번 경험에서 제가 가장 크게 느낀 건 AI의 한계가 아니라, AI와 개발자의 역할 분담이었습니다. ChatGPT는 일반적인 mPDF 사용법, 테이블 레이아웃 옵션, CSS 속성 설명 같은 공개된 정보를 정리해주는 데는 충분히 유용했습니다. 그런데 제가 맞닥뜨린 문제처럼 특정 버전에서만 나타나는 비정형 동작, 그것도 특정 속성 조합이 맞물렸을 때만 발생하는 버그는 AI가 답을 알고 있을 가능성이 애초에 낮습니다. 학습 데이터에 없거나, 있어도 희소한 사례니까요.
mPDF는 PHP 기반으로 HTML을 PDF로 변환해주는 오픈소스 라이브러리입니다. UTF-8 인코딩, RTL(오른쪽에서 왼쪽으로 쓰는 언어, 아랍어·히브리어 등), CJK(중국어·일본어·한국어) 문자 지원을 포함해 북마크, 워터마크, 바코드, 패스워드 보호, PDF/A 규격 등 상당히 넓은 범위의 기능을 제공합니다(출처: mPDF 공식 문서). 기능이 많은 만큼, 내부 동작이 복잡하고 예외 케이스도 많습니다. 제 경험상 이건 공식 문서만으로는 전부 파악이 불가능한 영역입니다.
결국 이런 문제를 풀 수 있는 건, 증상을 읽고 원인을 가설로 세운 뒤 하나씩 검증해가는 개발 감각입니다. 그게 단순한 코딩 실력과는 다른, 경험에서 나오는 감각이라는 생각이 들었습니다. AI가 아무리 발전해도, 이 감각을 완전히 대체하기는 어려울 것 같습니다.
자주 묻는 질문
Q. mPDF에서 HTML 테이블이 브라우저와 다르게 출력되는 이유가 뭔가요?
A. mPDF는 브라우저의 렌더링 엔진이 아니라 자체적으로 구현한 오토레이아웃 알고리즘으로 테이블을 계산합니다. 이 과정에서 페이지 크기 제약, width 속성 처리 방식, colspan 셀 해석 등이 브라우저와 다르게 동작할 수 있습니다. 특히 colspan이 걸린 셀에 width를 명시하면 예상치 못한 레이아웃이 나올 수 있으니, 변환 후 반드시 별도로 확인하는 습관이 필요합니다.
Q. mPDF 테이블이 전체적으로 축소되어 출력될 때 어떻게 확인해야 하나요?
A. 테이블 전체가 비율 축소될 때는 먼저 각 열의 width 합산이 페이지 또는 라벨 너비를 초과하는지 확인해보시는 것이 좋습니다. colspan 셀에 지정된 width 값이 의도치 않게 개별 열 너비로 인식되어 합산을 초과하는 경우가 있습니다. shrink_tables_to_fit 옵션 값도 함께 점검해보시면 원인을 좁히는 데 도움이 됩니다.
Q. mPDF에서 colspan 셀에 width를 쓰면 안 되나요?
A. 꼭 쓰면 안 된다는 규칙은 없지만, 특정 버전에서 해당 값이 다음 행의 열 너비로 상속되는 문제가 보고되어 있습니다. 가능하다면 colspan이 적용된 셀에는 width를 생략하고, 개별 열에 각각 너비를 지정하는 방식이 더 안정적입니다. 어쩔 수 없이 써야 한다면, 출력 전 preg_replace로 해당 속성만 제거하는 우회 방법도 유효합니다.
Q. ChatGPT에 mPDF 버그를 물어봐도 답을 못 찾는 경우가 많은데, 어떻게 해야 하나요?
A. AI는 공개된 문서나 자주 논의된 사례에는 강하지만, 특정 버전에서만 나타나는 비정형 버그는 학습 데이터 자체가 부족할 수 있습니다. 이런 경우에는 mPDF GitHub 이슈 트래커나 Stack Overflow에서 비슷한 증상을 직접 검색해보시는 게 훨씬 빠릅니다. 증상을 최대한 구체적으로 기술하고, mPDF 버전 번호까지 명시해서 검색하면 유사 사례를 찾을 가능성이 높아집니다.
3시간짜리 삽질이 결국 preg_replace 한 줄로 끝났을 때, 황당함 반 뿌듯함 반이었습니다. 개발에서 가장 시간이 오래 걸리는 건 코드를 짜는 일이 아니라 버그의 원인을 찾는 일이라는 걸 이번에 다시 한번 실감했습니다. mPDF처럼 내부 구현을 직접 들여다보기 어려운 라이브러리를 쓸 때는, 브라우저 결과를 맹신하지 말고 PDF 변환 후 결과를 항상 단계별로 확인하는 것이 제가 얻은 가장 현실적인 교훈입니다.
—
참고: https://mpdf.github.io/